سایت خبری
famaserver
  • صفحه نخست
  • تکنولوژی
  • علم و دانش
  • بازی
  • فناوری
  • اینترنت
  • موبایل
سایت خبری
برترین عناوین خبری
  • خرید بیمه: سنتی یا آنلاین؟ کدامیک تجربه بهتری برای مشتریان ایجاد می‌کند؟

سرتیتر خبرها

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

8 ساعت پیش

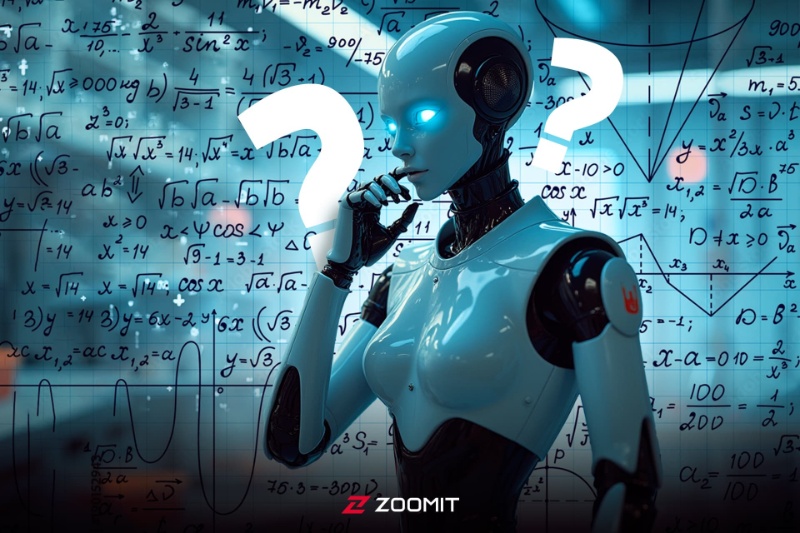
وقتی هوش مصنوعی به دیوار ریاضی می‌خورد؛ نمره زیر ۵ درصد در المپیاد آمریکا!
زمان انتشار: 20 آوریل 2025 ساعت 14:30

دسته بندی: تکنولوژی

شناسه خبر: 913091

زمان مطالعه: 4 دقیقه

وقتی هوش مصنوعی به دیوار ریاضی می‌خورد؛ نمره زیر ۵ درصد در المپیاد آمریکا!

وقتی هوش مصنوعی به دیوار ریاضی می‌خورد؛ نمره زیر ۵ درصد در المپیاد آمریکا!

در سال‌های اخیر، حضور هوش مصنوعی در عرصه‌های مختلف علمی، به‌ویژه ریاضیات، روز‌به‌روز پررنگ‌تر شده است. حوزه‌ای که تا مدت‌ها به‌عنوان عرصه‌ای ناب برای استدلال انسانی تلقی می‌شد، اکنون شاهد قدرت‌نمایی مدل‌های زبانی بزرگ (LLMS) است. اما آیا مدل‌های هوش مصنوعی می‌توانند پابه‌پای ذهن انسان، مسائل پیچیده‌ی ریاضی را حل کنند؟

پویش پورمحمد

هوش مصنوعی چطور کار می‌کند؟ طرز کار مدل‌های زبانی بزرگ به زبان ساده

هوش مصنوعی چطور کار می‌کند؟ طرز کار مدل‌های زبانی بزرگ به زبان ساده
مطالعه ’22

مطالعات اخیر نشان داده‌اند که مدل‌های به‌کار رفته در ChatGPT در آزمون‌های معتبر ریاضی برای دانش‌آموزان دبیرستانی ازجمله AIME و HMMT که تنها پاسخ نهایی را می‌سنجند، عملکرد چشمگیری داشته‌اند. بااین‌حال، این نوع ارزیابی‌ها لزوماً معیار دقیقی برای سنجش توانایی منطقی و استدلالی این مدل‌ها نیستند. تولید اثبات‌های دقیق و مرحله‌به‌مرحله نیازمند مهارت‌هایی فراتر از محاسبه‌ی پاسخ نهایی است.

فهرست مطالب
  • دقت مدل‌های زبانی در آزمون USAMO:‌ کمتر از ۵درصد
  • شکست تمام عیار هوش مصنوعی در اثبات مسائل ریاضی پیچیده
  • مقایسه عملکرد مد‌ل‌ها در استدلال ریاضی
  • دلایل شکست هوش مصنوعی در ریاضی
  • پشت پرده‌ خطاها؛ منطق گمشده‌ هوش مصنوعی
  • هوش مصنوعی، داوری مهربان‌تر از انسان
  • مهارت یا تقلید؟
  • نوآوری گمشده؛ چرا ماشین‌ها نمی‌توانند به‌خوبی استدلال کنند؟

در همین راستا، مطالعه‌ای جدید به بررسی عملکرد مدل‌های زبانی در سطحی به‌مراتب دشوارتر پرداخته است: المپیاد ریاضی ایالات متحده آمریکا (USAMO). نتایج این پژوهش نشان می‌دهد که حتی پیشرفته‌ترین مدل‌ها نیز در این آزمون عملکرد بسیار ضعیفی داشته‌اند؛ به‌طوری‌که میانگین امتیاز آن‌ها کمتر از ۵ درصد بوده است. ماجرا چیست؟

کپی لینک

دقت مدل‌های زبانی در آزمون USAMO:‌ کمتر از ۵درصد

به‌منظور بررسی دقیق‌تر توانایی مدل‌های زبانی در زمینه‌ی استدلال ریاضی، پژوهشی جدید به ارزیابی عملکرد این مدل‌ها در المپیاد ریاضی ایالات متحده آمریکا پرداخته است؛ رقابتی در سطح بالا که از شرکت‌کنندگان انتظار می‌رود پاسخ‌هایی مبتنی‌بر اثبات‌های کامل، شفاف و منسجم ارائه دهند.

حتما بخوانید : ادرار درمانی: افسانه یا علم؛ آیا نوشیدن ادرار واقعاً مفید است؟
اشتراک گذاری

اخبار مرتبط

  • ممنوعیت استفاده از چت‌جی‌پی‌تی و کلاد در ادارات دولتی سوئد؛
بازگشت به ابزارهای مایکروسافت
    ممنوعیت استفاده از چت‌جی‌پی‌تی و کلاد در ادارات دولتی سوئد؛ بازگشت به ابزارهای مایکروسافت 7 ساعت پیش
  • اعتراضات گسترده در ردیت؛ انجمن r/opensource هوش مصنوعی و
زبان‌های غیر از انگلیسی را ممنوع کرد
    اعتراضات گسترده در ردیت؛ انجمن r/opensource هوش مصنوعی و زبان‌های غیر از انگلیسی را ممنوع کرد 7 ساعت پیش
  • فناوری‌های دیجیتال جایگزین مشاوران بیمه نمی‌شوند؛ روایت
ازکی‌سلر از آینده بازار
    فناوری‌های دیجیتال جایگزین مشاوران بیمه نمی‌شوند؛ روایت ازکی‌سلر از آینده بازار 7 ساعت پیش
  • سومین دوره المپیک امنیت سایبری آبان‌ماه برگزار
می‌شود
    سومین دوره المپیک امنیت سایبری آبان‌ماه برگزار می‌شود 7 ساعت پیش

دیدگاه ها

دیدگاهتان را بنویسید لغو پاسخ

نشانی ایمیل شما منتشر نخواهد شد. بخش‌های موردنیاز علامت‌گذاری شده‌اند *

دسته بندی موضوعات

  • ارتباطات 181
  • امنیت 317
  • اینترنت 3488
  • بازی 8854
  • برنامه نویسی 53
  • تبلیغات 25
  • تکنولوژی 35988
  • دانش‌بنیان 1
  • رمز ارز 1252
  • سیستم عامل 275
  • شبکه اجتماعی 705
  • علم و دانش 17348
  • فناوری 8762
  • کاریکاتور 556
  • کسب و کار 816
  • موبایل 983
  • میزبانی وب 50
  • نرم افزار - سخت افزار 544

جدیدترین مقالات

  • 8 ساعت پیش
  • 8 ساعت پیش
  • 8 ساعت پیش
  • 8 ساعت پیش
  • 8 ساعت پیش

میزبانی در هاست ویندوز فاماسرور